In de juridische test van Harvey AI stuurt een partner een associate een opdracht van vijftig woorden. Zoek in de dataroom alle change-of-control-bepalingen, schat het risico voor de overname in en lever een memo aan voor het bestuur. De associate levert een keurig stuk. Stel dat van de negen juridische problemen die in de contracten verstopt zitten, er acht in staan. Het memo gaat terug.
Die test heet Harvey’s Legal Agent Benchmark, kortweg LAB. Harvey is het Amerikaanse bedrijf achter juridische AI voor grote advocatenkantoren. Het voorbeeld hierboven komt uit Harvey’s eigen uitleg.
De regel erachter: een taak telt alleen als geslaagd als élk controlepunt klopt. “A deal-team report that identifies eight of ten risks is not 80% useful; it is materially incomplete.”
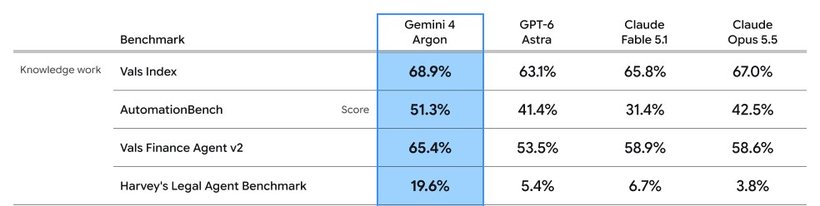
Op woensdagavond 30 september gebruikte Google precies deze test om zijn nieuwe model Gemini 4 Argon aan te prijzen.
Wat meet de Harvey AI-test precies?
Harvey maakte LAB in mei 2026 openbaar. De eerste versie heeft ruim 1.200 opdrachten verdeeld over 24 rechtsgebieden, zoals fusies en overnames, arbeidsrecht en belastingen. Elke opdracht is gemaakt uit echte zaken van advocaten.
- De AI krijgt een korte opdracht, gemiddeld vijftig woorden, zoals een partner die aan een associate geeft.
- Hij moet zelf de juiste stukken vinden in een map met dossierbestanden, e-mails en sjablonen.
- Hij levert een echt werkstuk op: een memo, een spreadsheet of een presentatie.
- Juristen hebben per opdracht een lijst met controlepunten geschreven, in totaal meer dan 75.000. Het change-of-control-memo heeft er 57.
- Eén gemist punt en de hele opdracht telt als niet gehaald.
Google haalt zijn scores voor deze test volgens het eigen methodedocument bij Vals AI, dat de ranglijst bijhoudt.
94% van de punten goed, 19,6% van de opdrachten af
Op de ranglijst van Vals AI staan voor elk model twee cijfers. Het eerste is hoeveel controlepunten het model goed had. Het tweede is hoeveel opdrachten helemaal foutloos waren.
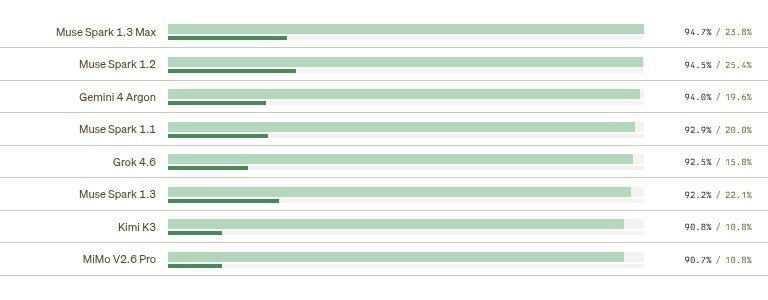
Gemini 4 Argon had 94,0% van alle controlepunten goed. Toch was maar 19,6% van zijn opdrachten af. In vier van de vijf gevallen miste hij dus iets, al was het maar één punt. Voor een jurist is dat precies het verschil tussen een concept en een stuk dat je kunt versturen.
Op deze test is Argon niet de beste
Google zet Argon alleen naast drie modellen van OpenAI en Anthropic. Daartegen wint het ruim. Maar op de ranglijst van Vals AI staan ruim zeventig modellen, en daar staat Argon op plek vijf. De vier modellen erboven komen allemaal van Meta.
| Model | Foutloos | Per taak |
|---|---|---|
| Muse Spark 1.2 | 25,4% | $2,09 |
| Muse Spark 1.3 Max | 23,8% | $2,24 |
| Muse Spark 1.3 | 22,1% | $2,73 |
| Muse Spark 1.1 | 20,0% | $0,80 |
| Gemini 4 Argon | 19,6% | $10,55 |
| Claude Fable 5.1 | 6,7% | $46,21 |
| GPT-6 Astra | 5,4% | $26,16 |
| Claude Opus 5.5 | 3,8% | $21,38 |
Muse Spark 1.2 haalt meer opdrachten foutloos voor ongeveer een vijfde van de prijs. Dat verdwijnt uit beeld als je alleen de tabel van Google leest. Het cijfer van Google klopt, maar de vergelijking is gekozen.
Streng nakijken is geen reden om 94% weg te zetten
Wie AI in de rechtspraktijk wantrouwt, leest hier “vier van de vijf keer fout”. Dat is ook te kort door de bocht. Een memo met 56 van de 57 punten goed scheelt een advocaat uren werk. Het moet alleen nog worden nagelopen.
De test zegt niet dat het model onbruikbaar is. Hij zegt dat je het werk niet ongecontroleerd de deur uit kunt doen.
En er zit een grens aan wat LAB meet. De opdrachten komen uit de praktijk van grote, vooral Amerikaanse kantoren. Nederlands recht, een bezwaarschrift aan de gemeente of een huurconflict zitten er niet in.
Hoe goed Argon of welk ander model dan ook het Nederlandse recht beheerst, blijkt hier niet uit. Wie een tool voor Nederlandse zaken zoekt, heeft meer aan een overzicht als juridische ai-tools vergeleken. Onze eigen zoeker toetsen we met vaste Nederlandse vragen, zoals je leest in zo meten wij.
Maak je eigen afvinklijst voor je volgende AI-concept
Het slimste uit LAB kun je zelf gebruiken. Laat je een AI een brief of bezwaar opstellen, schrijf dan eerst op wat er in moet staan.
Voor een bezwaarschrift staat dat gewoon in artikel 6:5 van de Awb: je naam en adres, de datum, een omschrijving van het besluit, je gronden en je handtekening. Ons bezwaarschrift voorbeeld laat zien hoe dat eruitziet. Vink die punten af voor je iets verstuurt.
Mist er één, dan is het concept niet af, hoe goed de rest ook leest. Precies zo keurt Harvey. Vraag bij twijfel of een punt juridisch klopt een advocaat of rechtswinkel. Chatbots zeggen daar zelf ook iets over: Anthropic laat Claude Fable 5 volgens zijn eigen prompt geen juridisch advies geven.
Wanneer telt Argon echt mee voor juristen?
Voorlopig niet. Google geeft Argon eerst alleen aan een groep “trusted cyber defenders”. Advocatenkantoren kunnen het nog niet gebruiken. Pas als het model breed beschikbaar is, blijkt of die 19,6% ook buiten een test overeind blijft, en of Meta dan nog steeds bovenaan staat.
Harvey heeft beloofd LAB uit te breiden naar juristen in bedrijven en naar andere vakgebieden. Komt er ooit een versie met Europese of Nederlandse zaken, dan wordt deze ranglijst pas echt interessant voor juristen hier. Tot die tijd blijft de beste ai rechtshulp een model plus iemand die elk punt nakijkt.